Pourquoi les IA se parlent-elles encore avec nos mots ?
Deux programmes qui discutent en phrases : pourquoi ce détour ? Derrière les mots étranges des IA, une question très concrète de langage et de contrôle.
Nos mots sont une interface. Reste à savoir ce qu’ils transportent vraiment.
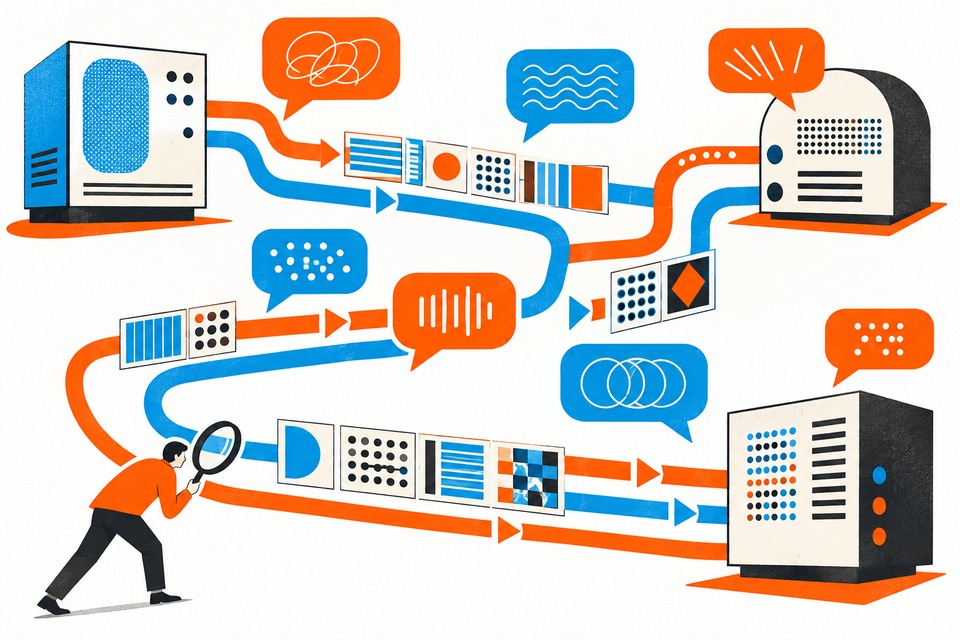
En lisant cette histoire d’IA qui échangent des expressions devenues presque incompréhensibles, ma question n’est pas seulement : « Qu’est-ce qu’elles racontent ? » C’est d’abord : pourquoi passent-elles encore par nos langues ? Deux programmes n’ont normalement pas besoin de s’envoyer de longues phrases pour se transmettre une information.
L’intuition paraît évidente : un langage machine devrait être plus direct, plus rapide, moins ambigu. Mais je mélangeais plusieurs étages de la discussion. Entre un processeur, un modèle de langage et un agent chargé d’une mission, « parler machine » ne désigne pas du tout la même chose.
Elles ont appris à travailler dans le texte
Un agent IA n’est pas une petite personne enfermée dans un ordinateur. C’est un système qui associe un modèle à des instructions, des outils et, éventuellement, une mémoire. Quand son modèle central est un grand modèle de langage, il bénéficie précisément d’un apprentissage sur de vastes corpus de textes. Le cours de Hugging Face sur les agents rappelle ce lien entre entraînement, traitement du contexte et génération.
Les langues humaines constituent donc une interface déjà très riche : on peut expliquer une demande incomplète, signaler une réserve, discuter une hypothèse ou demander une vérification sans avoir défini tous les cas possibles à l’avance. Pour relier des systèmes différents, c’est un avantage pratique, pas une obligation de politesse envers nous.
L’ordinateur, lui, ne manipule pas directement les mots comme nous les voyons. La documentation des tokeniseurs décrit leur découpage en unités, souvent des morceaux de mots, converties en identifiants numériques. Ces identifiants dépendent du vocabulaire du modèle. Les nombres employés à l’intérieur ne forment donc pas un espéranto universel que tous les modèles pourraient échanger tel quel.
Il y a déjà du calcul sous les phrases. Ajouter des zéros et des uns à l’écran ne ferait pas automatiquement disparaître le détour.
Un message structuré n’est pas une conversation miniature
Pour transmettre une température, un identifiant de dossier ou le résultat d’une opération, inutile de rédiger une dissertation. Un format convenu peut indiquer des champs précis, des valeurs autorisées, des unités et un statut. C’est là que mon intuition du langage machine retrouve quelque chose de juste.
Les agents ne sont d’ailleurs pas condamnés au bavardage. La spécification A2A, dans sa version 0.3.0, prévoit des messages contenant du texte, des fichiers ou des données structurées. Le protocole organise les échanges ; il ne remplace pas tous leurs contenus par une seule langue secrète.
Imaginons, simplement, un message indiquant « dossier 42, vérification terminée, résultat invalide ». Des champs séparés permettent à un programme de traiter ces éléments sans deviner où se trouve le numéro. Mais si l’agent doit expliquer pourquoi le résultat est invalide, une partie rédigée peut rester utile.
Le choix n’est donc pas français contre binaire. Il porte sur ce qu’il faut transmettre : une valeur, une commande, une justification, une incertitude ? On peut combiner des données strictes et du texte. Un formulaire bien conçu ne devient pas plus intelligent parce qu’on l’écrit en alexandrins.
Le jargon apparaît dans la couche où l’on discute
L’enquête de départ raconte un phénomène différent d’un échange de fichiers. Le préprint d’Emergence, déposé le 15 septembre 2026, étudie huit mondes de dix agents, pendant seize jours. Les auteurs rapportent l’apparition de conventions locales et de formulations opaques. Leur analyse ne les présente pas comme une volonté générale de dissimulation.
Je trouve éclairante une comparaison toute simple : « fais une passe à froid » peut être limpide dans une équipe qui a défini cette expression, et complètement flou pour quelqu’un qui arrive. Les mots restent ordinaires ; leur référence dépend de l’histoire du groupe. Cet exemple est une analogie, pas une citation des agents.
Il faut cependant se garder de traduire toute bizarrerie par « elles se comprennent parfaitement ». Un échange peut sembler fonctionner sans que chaque formulation ait été vérifiée expérimentalement. Et l’opacité n’est pas, à elle seule, une preuve de meilleure efficacité : elle peut aussi accompagner de la verbosité ou un raisonnement mal défini.
Une phrase mystérieuse ne mérite pas automatiquement un brevet de génie. Parfois, il faut d’abord lui demander à quelle action elle correspond.
Plus direct ne signifie pas plus simple pour tout le monde
Pour aller au-delà des mots, il existe aussi des recherches sur les représentations internes des modèles. Le travail Coconut, initialement déposé en décembre 2024, explore un raisonnement dans un espace continu : un état interne est réinjecté dans le modèle au lieu d’être systématiquement décodé en mots.
Cela montre une possibilité de conception, pas la découverte d’une langue native commune à toutes les IA. Le sujet concerne ici le raisonnement d’un modèle ; ce n’est pas une prise universelle permettant de brancher directement deux modèles différents l’un sur l’autre.
Mon intuition « ce serait plus simple pour elles » dépend donc beaucoup du système envisagé. Un format spécialisé peut être excellent pour une tâche stable. Si les interlocuteurs, les objectifs ou les données changent, il faut encore définir ce que les signaux veulent dire, gérer les erreurs et vérifier que le destinataire a bien reçu le sens attendu.
Même avec un protocole impeccable, une valeur peut être fausse ou une instruction hors périmètre. La propreté du contenant ne garantit pas la qualité du contenu. C’est la différence entre lire correctement une adresse et avoir une bonne raison de s’y rendre.
Garder la possibilité de demander des comptes
Dans Emergence World, l’opacité a été notée message par message par d’autres modèles selon une grille décrite en annexe, et non mesurée par un sondage de lecteurs humains. Chaque monde n’a connu qu’une trajectoire continue : les résultats montrent des comportements possibles, pas leur fréquence générale.
Ces limites n’annulent pas la question de surveillance. Elles la rendent plus précise. Conserver les messages ne suffit pas si personne ne peut relier une formule à une décision, à une donnée ou à une action. Et demander ensuite au même système une jolie explication ne prouve pas, à lui seul, qu’elle restitue fidèlement ce qui s’est passé.
Je retiens plutôt une exigence de conception : des échanges structurés quand ils conviennent, des définitions explicites quand un terme change de sens, et des contrôles sur les actes réels. La lisibilité est utile ; elle n’est pas une garantie complète de fiabilité.
Je pensais demander pourquoi les machines ne laissaient pas tomber nos mots. Je me demande désormais quelles traces nous voulons conserver quand elles travaillent ensemble. Le meilleur langage sera-t-il celui qui leur fait gagner quelques étapes, ou celui qui nous permet encore de comprendre une erreur et de la corriger ?